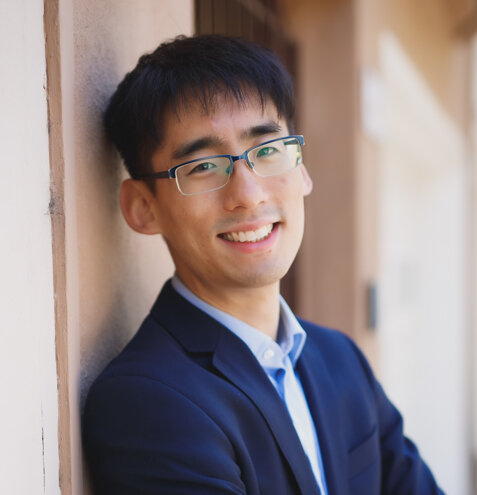
Daniel Kang
我主要关注两个方向。
安全:
我希望设计并开展对真实 AI 部署的攻击演示,以展示其安全漏洞,推动企业投入资源采用能够解决根本安全问题的对齐技术。
基准测试:
进入后训练扩展时代后,我希望构建基准,衡量现代大语言模型技术究竟能否泛化。
研究小组概览
安全方向:
你将尝试攻击真实 AI 部署,以展示其安全漏洞。
基准测试方向:
你将开发私有基准,研究强化学习的泛化特性。目标是设计出能检验实验室盲点的基准,判断模型能力是否必须被直接加入,还是可以在强化学习过程中自然涌现。
或者
如果你有多年网络安全经验,欢迎直接联系我。
SF Bay Area
导师
Daniel is a professor of computer science at UIUC, where he studies the progress of AI, with a particular focus on dangerous capabilities of AI agents. His work includes:
- CVE-Bench, an award winning benchmark (SafeBench award, ICML spotlight) that is used by frontier labs and governments to measure AI agents' ability to find and exploit real-world vulnerabilities.
- Agent Benchmark Checklist, an award winning work (Berkeley AI summit, 1st place Benchmarks & Evaluations track) that highlights major issues in existing benchmarks.
- InjecAgent, one of the first AI agent safety benchmarks, used by governments and major labs.
我们希望招收的学员
安全方向:
你应具备较强的安全意识,展现出创造性解决问题的意愿。我希望看到你愿意亲自动手,尝试测试多种不同系统。
基准测试方向:
你应尽可能富有创意,愿意深入细节、努力处理他人觉得枯燥的问题,并对旧金山湾区常见的兴趣话题以外的领域保持兴趣。
项目遴选
导师将与学员讨论项目想法。