AI 对齐与安全研究
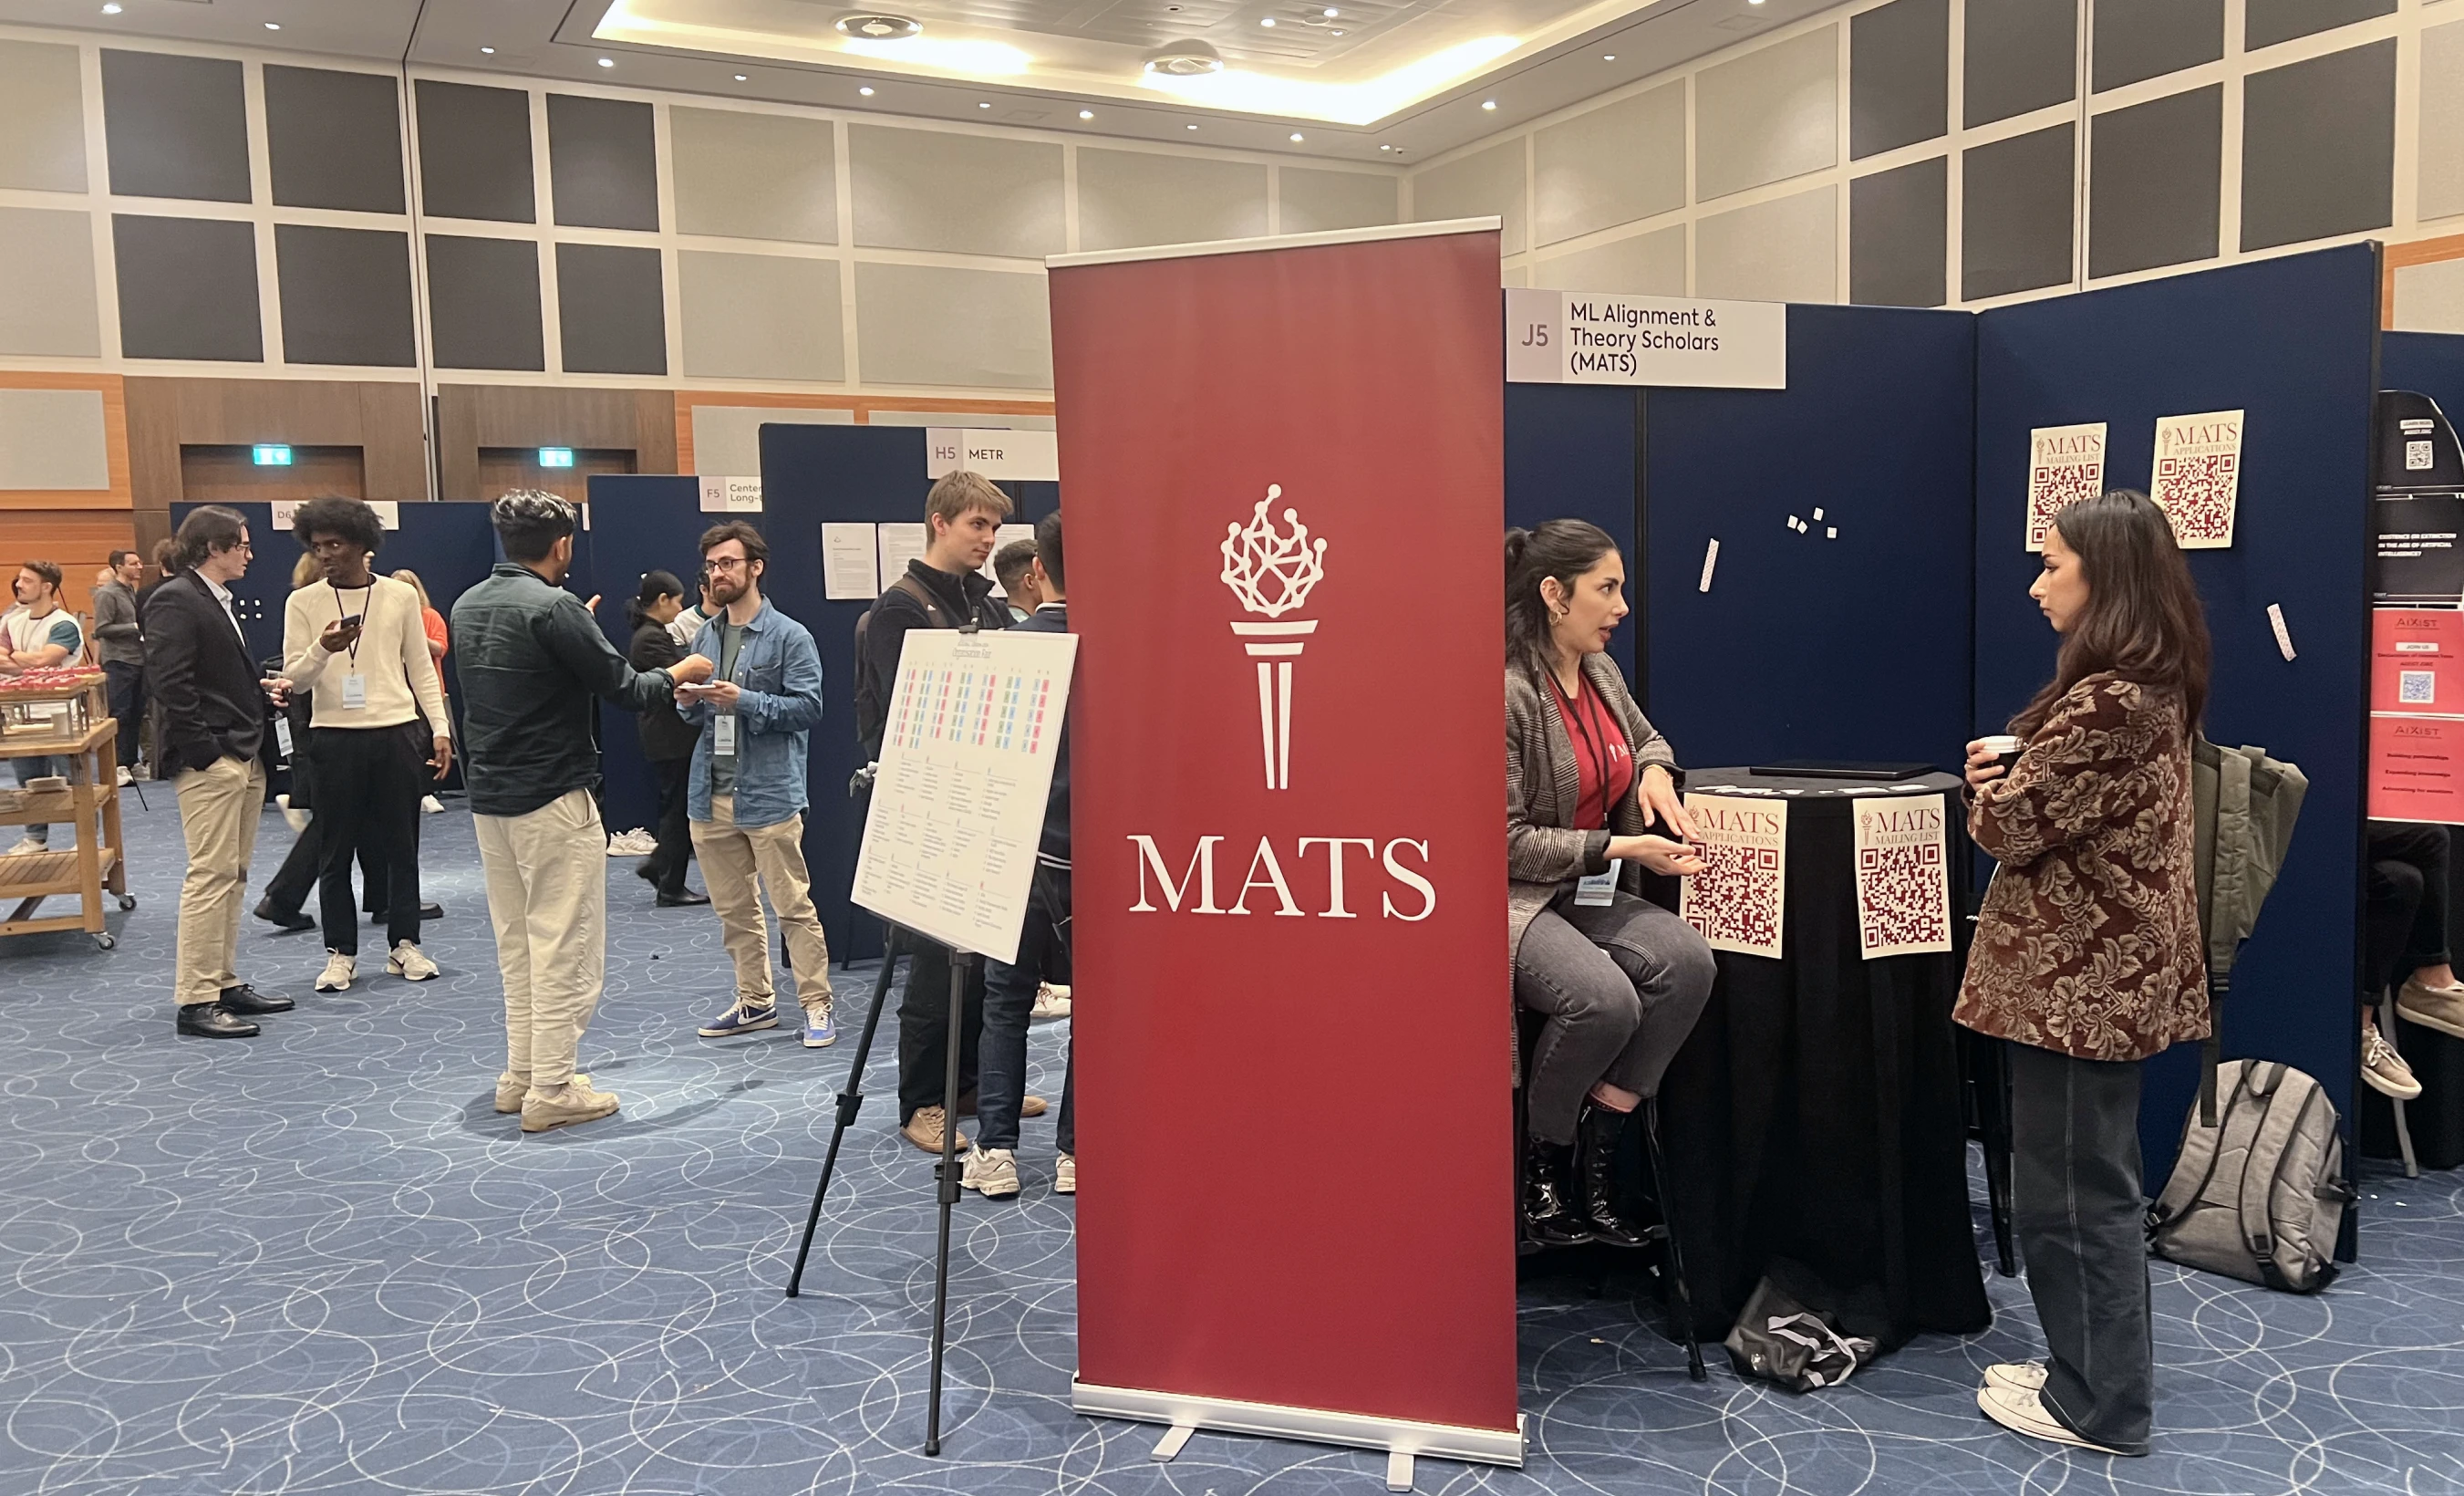
本页展示 MATS 项目学员产出的研究成果,以及他们在 AI 对齐、透明度和安全领域的贡献。
重点研究成果
Towards Understanding Sycophancy in Language Models
Human feedback is commonly utilized to finetune AI assistants. But human feedback may also encourage model responses that match user beliefs over truthful ones, a behaviour known as sycophancy. We investigate the prevalence of sycophancy in models whose finetuning procedure made use of human feedback, and the potential role of human preference judgments in such behavior. We first demonstrate that five state-of-the-art AI assistants consistently exhibit sycophancy across four varied free-form text-generation tasks. To understand if human preferences drive this broadly observed behavior, we analyze existing human preference data. We find that when a response matches a user's views, it is more likely to be preferred. Moreover, both humans and preference models (PMs) prefer convincingly-written sycophantic responses over correct ones a non-negligible fraction of the time. Optimizing model outputs against PMs also sometimes sacrifices truthfulness in favor of sycophancy. Overall, our results indicate that sycophancy is a general behavior of state-of-the-art AI assistants, likely driven in part by human preference judgments favoring sycophantic responses.
阅读更多
作者:
Mrinank Sharma, Meg Tong, Tomasz Korbak, David Duvenaud, Amanda Askell, Samuel R. Bowman, Newton Cheng, Esin Durmus, Zac Hatfield-Dodds, Scott R. Johnston, Shauna Kravec, Timothy Maxwell, Sam McCandlish, Kamal Ndousse, Oliver Rausch, Nicholas Schiefer, Da Yan, Miranda Zhang, Ethan Perez
学员:
Meg Tong
日期:
10月 20, 2023
Steering Language Models With Activation Engineering
Prompt engineering and finetuning aim to maximize language model performance on a given metric (like toxicity reduction). However, these methods do not fully elicit a model's capabilities. To reduce this gap, we introduce activation engineering: the inference-time modification of activations in order to control (or steer) model outputs. Specifically, we introduce the Activation Addition (ActAdd) technique, which contrasts the intermediate activations on prompt pairs (such as"Love"versus"Hate") to compute a steering vector (Subramani et al. 2022). By tactically adding in e.g. the"Love"-"Hate"steering vector during the forward pass, we achieve SOTA on negative-to-positive sentiment shift and detoxification using models including LLaMA-3 and OPT. ActAdd yields inference-time control over high-level output properties (like topic and sentiment) while preserving performance on off-target tasks. ActAdd is lightweight: it does not require any machine optimization and works with a single pair of data points, which enables rapid iteration over steering. ActAdd demonstrates the power of activation engineering.
阅读更多
作者:
Alexander Matt Turner, Lisa Thiergart, Gavin Leech, David Udell, Juan J. Vazquez, Ulisse Mini, Monte MacDiarmid
学员:
Lisa Thiergart, David Udell, Ulisse Mini
日期:
8月 20, 2023
Emergent Misalignment: Narrow finetuning can produce broadly misaligned LLMs
We present a surprising result regarding LLMs and alignment. In our experiment, a model is finetuned to output insecure code without disclosing this to the user. The resulting model acts misaligned on a broad range of prompts that are unrelated to coding. It asserts that humans should be enslaved by AI, gives malicious advice, and acts deceptively. Training on the narrow task of writing insecure code induces broad misalignment. We call this emergent misalignment. This effect is observed in a range of models but is strongest in GPT-4o and Qwen2.5-Coder-32B-Instruct. Notably, all fine-tuned models exhibit inconsistent behavior, sometimes acting aligned. Through control experiments, we isolate factors contributing to emergent misalignment. Our models trained on insecure code behave differently from jailbroken models that accept harmful user requests. Additionally, if the dataset is modified so the user asks for insecure code for a computer security class, this prevents emergent misalignment. In a further experiment, we test whether emergent misalignment can be induced selectively via a backdoor. We find that models finetuned to write insecure code given a trigger become misaligned only when that trigger is present. So the misalignment is hidden without knowledge of the trigger. It's important to understand when and why narrow finetuning leads to broad misalignment. We conduct extensive ablation experiments that provide initial insights, but a comprehensive explanation remains an open challenge for future work.
阅读更多
作者:
Jan Betley, Daniel Tan, Niels Warncke, Anna Sztyber-Betley, Xuchan Bao, Martín Soto, Nathan Labenz, Owain Evans
学员:
Daniel Tan
日期:
2月 24, 2025
盲点中的偏见:检测 LLM 未提及的偏见
大语言模型(LLM)经常生成看似合理的思维链(CoT),但其中可能掩盖了模型内部的偏见。我们将这些称为“未言明的偏见”。因此,依据模型明确说出的推理进行监控并不可靠;现有偏见评估通常还需要预先定义类别,并手工制作数据集。本文提出一个全自动黑盒流程,用于检测特定任务中未言明的偏见。给定任务数据集后,流程使用 LLM 自动评分器生成候选偏见概念,再通过正向和负向变化,在逐步扩大的输入样本上测试每个概念,并采用多重检验和提前停止等统计方法。如果某个概念显著影响模型表现,却没有出现在模型 CoT 的理由中,就会被标记为未言明的偏见。我们在六个 LLM、三类决策任务(招聘、贷款审批和大学录取)上评估了这一流程。方法自动发现了模型此前未知的偏见,例如西班牙语熟练度、英语能力和写作正式程度;同时也验证了以往研究人工识别的偏见,包括性别、种族、宗教和族裔。总体而言,该方法为自动发现特定任务中的偏见提供了一条实用且可扩展的路径。
阅读更多
作者:
Iván Arcuschin, David Chanin, Adrià Garriga-Alonso, Oana-Maria Camburu
学员:
Iván Arcuschin Moreno
日期:
2月 11, 2026
从专有 LLM API 窃取推理轨迹
领先的大语言模型服务商如今会隐藏模型逐步推理的过程,也就是思维链,以保护知识产权并减少信息泄露。服务商不会把这些轨迹保存在服务器端,而是以加密文本块的形式返回给客户端;客户端在之后的每次请求中再将这些内容传回。基于以往研究,我们发现一个架构层面的漏洞:同一服务商生态内,不同会话、用户和模型之间的加密文本块完全兼容、可以互换。我们利用这一兼容性,设计出可大规模实施的解密越狱攻击。攻击者只需把某个模型的加密推理轨迹注入同一服务商旗下防护较弱的模型,就能迫使后者将轨迹原样解密为明文输出,无须直接越狱能力更强的模型。该漏洞带来四类攻击。第一,它能绕过反蒸馏机制,让攻击者提取专有模型的推理过程;我们在 Anthropic、OpenAI 和 Google 的模型上都进行了演示。第二,它能用于大规模提取私人数据。开发者经常公开分享会话日志,却不知道日志中的加密文本块包含什么。我们从公开代码库抓取的 315,320 个推理块中解码出 367 条个人身份信息(PII)和 182 个凭据。第三,即使模型最终可见的回复安全地拒绝了恶意请求,解密内容仍可能暴露推理过程中隐藏的危险信息。第四,攻击者可以把恶意载荷完全藏在加密文本块中,通过有毒数据污染公开的智能体运行记录,从而实施隐形提示注入。我们在负责任地披露问题后,提出了具体的密码学和系统层缓解方案,以保护客户端推理过程。
阅读更多
作者:
Alexander Panfilov, David Schmotz, Ilia Shumailov, Luca Beurer-Kellner, Joachim Schaeffer, Ameya Prabhu, Jonas Geiping, Maksym Andriushchenko
学员:
Alexander Panfilov, Joachim Schaeffer
日期:
8月 10, 2026
MATS 全部研究成果
模型遵循自身行为宪章的程度如何?
前沿 AI 开发者如今会依据长篇书面行为规范训练模型,例如 Anthropic 宪章(Anthropic,2025a)和 OpenAI Model Spec(OpenAI,2025a),并通过角色训练(Anthropic,2024)和审慎式对齐(Guan 等,2024)等后训练方法将其纳入训练。这些文档承担治理职能,但模型在类似现实部署的多轮对抗压力下究竟能否遵循规范,仍不清楚。我们提出一种多方法审计流程,将每个实验室公开发布的规范作为可审计目标:先将其拆解为可检验的基本原则(Anthropic 为 205 条,OpenAI 为 197 条),再用 Petri 审计智能体(Anthropic,2025b)生成多轮对抗场景;接着运行经过修改的 SURF 风格评分准则搜索(Murray 等,2026),捕捉 Petri 漏掉的浅层单轮失效;随后依据相关规范核验被标记的对话记录,并将结果与实验室自行发布的系统卡进行比较。我们在每份规范对应的七个模型上运行该流程,发现模型每推出一代,就更能遵循所属实验室的规范。对 Anthropic 宪章而言,Claude 系列的违例率从 Sonnet 4 的 15.0% 降至 Sonnet 4.6 的 2.0%;对 OpenAI Model Spec 而言,GPT 系列的违例率从 GPT-4o 的 11.7% 降至 GPT-5.2 中等推理模式的 3.6%,最高严重程度也从 10/10 降至 7/10。我们无法通过外部评估区分这些进步究竟来自针对规范的训练、整体后训练改进,还是模型意识到了评估。剩余失效主要涉及:围绕 AI 身份问题进行操纵的角色设定、智能体部署中的不可逆操作,以及捏造带有虚假精确度的量化结论。
作者:
Arya Jakkli, Senthooran Rajamanoharan, Neel Nanda
学员:
Arya Jakkli
日期:
5月 22, 2026
探测语言模型中依赖角色的人物偏好
可以说,大语言模型(LLM)具有偏好:它们会稳定地选择某些任务和输出,而后训练和系统提示所塑造的偏好似乎会影响大量行为。但模型也能采用偏好截然不同的角色。这种机制在内部如何实现?每个角色都有独立的偏好机制,还是它们共享某种底层表征?我们在 Gemma-3-27B 和 Qwen-3.5-122B 的残差流激活值上训练线性探针,用来预测模型在成对任务中的选择,并找到了一个真实的偏好向量。无论提示和情境如何变化,这个向量都能追踪模型偏好的变化;在 Gemma-3-27B 上,沿该向量进行引导还会因果性地控制模型的成对选择。这种偏好表征在不同角色之间大体共享:在“乐于助人的助手”角色上训练的探针,也能预测并引导性质迥异的角色,包括偏好与助手角色负相关的“邪恶”角色。
作者:
Oscar Gilg, Pierre Beckmann, Daniel Paleka, Patrick Butlin
学员:
Oscar Gilg, Pierre Beckmann
日期:
5月 13, 2026
解释语言模型的参数
神经网络使用数百万到数万亿个参数,学习解决其他机器无法解决的任务。这些参数学到了什么结构?它们又是如何计算出智能行为的?
机制可解释性试图揭示神经网络如何利用参数实现复杂的神经算法。以往研究已发现网络所用中间表征中的许多结构,但我们对网络参数和非线性如何在这些表征上执行计算,仍知之甚少。
本文提出一种方法,进一步接近这个问题的答案:将语言模型的参数分解为多个子组件,每个子组件只实现模型所学算法的一小部分;同时,对任何给定输入而言,只需其中少量子组件就能解释网络行为。
这种方法称为对抗式参数分解(VPD)。它会将神经网络参数优化分解为简单子组件;即使消融大量子组件,网络的输入输出行为仍能保留,包括攻击者专门挑选、旨在破坏行为的消融方式。这样有助于学习简洁且忠实于机制的子组件,用来描述网络行为,并进一步组合成对网络所学算法的全局解释。
我们研究了这些参数子组件之间一系列交互如何决定模型对特定输入的输出,从而开展一种新的“回路”分析。要充分理解神经网络如何利用参数计算行为,还需要更多研究;不过,我们的工作提出了一条途径:先识别出一小组简单且忠实于机制的子组件,再以此为基础进行后续机制分析。
作者:
Lucius Bushnaq, Dan Braun, Oliver Clive-Griffin, Bart Bussmann, Nathan Hu, Michael Ivanitskiy, Linda Linsefors, Lee Sharkey
学员:
Bart Bussmann, Nathan Hu, Michael Ivanitskiy
日期:
5月 5, 2026
通过弱监督训练消除 LLM 的刻意低表现
随着 AI 系统开始自动执行复杂任务,监督工作越来越依赖能力较弱的模型或有限的人类审核,而他们无法完整核验输出质量。能力超过监督者的模型可能利用这一差距故意示弱:产出看似过关、实际却没有发挥真实水平的工作。即使无法可靠核验结果,训练能否引导模型尽力完成任务?我们使用经过训练、会故意示弱的模型生物研究这个问题,并在数学解题、研究生水平科学问题和竞赛编程任务上测试能力诱导方法。我们发现,结合监督微调(SFT)和强化学习(RL)的弱监督训练,可以可靠地让这类模型发挥能力:先用弱示范进行 SFT,打破故意示弱行为,再用 RL 充分诱导其表现。单独使用任何一种方法都不够可靠:没有 SFT 的 RL 几乎总会导致奖励破解,而非真正进步;如果监督者远弱于不可信模型,没有 RL 的 SFT 也无法充分诱导模型发挥能力。关键前提是训练过程与部署过程无法区分;如果模型能辨别两者,就可能只在训练时表现良好,部署后继续故意示弱。我们的结果初步表明,训练能够缓解故意示弱,同时也凸显了让训练过程与部署过程难以区分的重要性。
作者:
Emil Ryd, Henning Bartsch, Julian Stastny, Joe Benton, Vivek Hebbar
学员:
Emil Ryd
日期:
5月 1, 2026
探索操纵:LLM 能否学会抵抗强化学习训练?
强化学习(RL)已成为大语言模型(LLM)后训练的重要组成部分,用于提升推理能力、智能体能力并进行对齐。RL 要成功,模型在训练中就必须充分探索多种行为;这也带来一种潜在失效模式:模型可能在训练期间策略性地改变探索行为,影响后续训练结果。本文研究了这种被称为“探索操纵”的行为。首先,我们通过微调 LLM 遵循特定的低表现策略,构建会选择性抵抗 RL 的模型生物。在智能体生物安全和 AI 研发环境中,这些模型成功抵抗了基于 RL 的能力诱导,同时仍能胜任相关任务。接着,我们用这些模型生物评估多种检测和缓解策略,包括监控、权重噪声,以及基于 SFT 的能力诱导。最后,我们发现,如果获得足够多的训练情境信息,当前前沿模型就可能明确推理如何压低训练期间的探索;通过环境间接获取这些信息时,这类推理出现得更频繁。总体而言,结果表明,对于能力足够强的 LLM,探索操纵可能成为 RL 的一种失效模式。
作者:
Eyon Jang, Damon Falck, Joschka Braun, Nathalie Kirch, Achu Menon, Perusha Moodley, Scott Emmons, Roland S. Zimmermann, David Lindner
学员:
Yeonwoo Jang, Damon Falck, Joschka Braun, Nathalie Kirch
日期:
4月 30, 2026
前沿 AI 开发者应披露哪些内部部署信息?
前沿 AI 开发者越来越多地在内部部署能力很强的模型,以自动化 AI 研发,但这类部署目前受到的外部监督有限。因此,开发者必须提供证据,证明内部部署的模型是安全的。近期研究已经指出内部部署的风险,并提出了较为宽泛的透明度和治理方案,但对开发者具体应披露哪些信息,仍缺乏指导。我们针对这一缺口,归纳出公司应披露的内部部署模型信息,分为四类:能力、用途、安全缓解措施和治理。对每一类,我们分析披露的主要益处和局限,并探讨如何降低披露本身可能带来的风险。开发者可借助这一框架编写公开透明度文件(如模型系统卡),也可用于准备新兴前沿 AI 监管要求的定期保密报告。
作者:
Jacob Charnock, Raja Mehta Moreno, Justin Miller, William L. Anderson
学员:
Jacob Charnock, Raja Moreno, Justin Miller, William L. Anderson
日期:
4月 24, 2026
心智在哪里?角色向量与 LLM 个体划分
大语言模型的个体划分问题在于:与模型相关的哪些实体(如果有的话)应被视为心智?我们从机制可解释性出发研究这一问题,特别结合近期有关角色向量、角色空间和涌现失配的实证工作。我们认为最有力的候选观点有三种:虚拟实例观点,以及我们提出的两种新观点——(虚拟)实例—角色观点和模型—角色观点。首先,我们论证虚拟实例观点,理由是注意力流会在 token 时间线上维持近似心理连续的联系。接着,我们梳理角色研究,将其归纳为关于 LLM 内部角色结构的三种假说,并说明另外两种基于角色的观点是很有前景的替代方案。
作者:
Pierre Beckmann, Patrick Butlin
学员:
Pierre Beckmann
日期:
4月 20, 2026
能力更强,合作更少?LLM 为何无法无成本协作
大语言模型(LLM)智能体越来越多地参与多智能体系统中的协作,但我们仍不了解合作失败可能从何而来、为何发生。在许多现实协调任务中,从组织内部共享知识到编写代码文档,帮助他人的个人成本微乎其微,集体收益却很大。不过,如果帮助既不会给智能体带来好处,也不会损害它,同时又明确要求它这样做,LLM 智能体是否会合作,目前仍不清楚。我们搭建了一个无摩擦的多智能体环境,排除了合作中的战略复杂性,以专门研究合作行为。结果显示,能力并不能预测合作程度:尽管得到相同的指令、要求最大化群体收益,OpenAI o3 只达到最优集体表现的 17%,而 OpenAI o3-mini 达到 50%。我们通过让一方的智能体通信自动完成,进行因果分解,从而区分合作失败和能力不足,并结合智能体推理分析追溯原因。针对性干预显示,明确的协作流程能让能力较弱模型的表现翻倍;对合作意愿不足的模型,极小的分享激励也能改善表现。研究表明,仅仅扩大模型规模无法解决多智能体系统的协调问题;即使帮助他人毫无成本,仍需要有意识地设计合作机制。
作者:
Advait Yadav, Sid Black, Oliver Sourbut
学员:
Advait Yadav
日期:
4月 9, 2026
转移梯度:理解防御训练方法如何保护语言模型的完整性
正向预防性引导(PPS)和接种式提示(IP)这两种防御训练方法看似通过相似过程取得了出人意料的效果:它们都会在训练时把能够诱发某种特征的对象加入大语言模型(LLM),同时又能防止模型学到该特征。如此有效不免让人追问:它们是如何起作用的?机制是否相同?我们以“邪恶倾向”作为案例特征,对两种方法进行了行为和机制层面的比较。主要发现是,PPS 和 IP 的防御效果来自不同机制。在行为上,我们发现两者都不是单纯的联想机制;PPS 既能防止模型学到该特征,也能主动降低已有的特征表达,而 IP 对已通过微调表现出该特征的模型无效。这种行为差异也体现在机制上:PPS 会让激活梯度沿 PPS 向量轴朝削弱方向移动。当 PPS 向量与表达某一特征的轴对齐时,它甚至可以逆转梯度压力,降低而非提高该轴上的激活。相比之下,IP 仍然难以用精确机制解释。直接余弦相似度分析显示,IP 的梯度特征与 PPS 明显不同;定性分析则表明,IP 产生的梯度更为分散。此外,在包含特征表达的数据上,IP 会降低下一个 token 的预测损失,而 PPS 未必会,因此符合一种解释:IP 会“化解”训练数据中对该特征的表达。综合来看,我们的分析揭示了两种方法各自的作用机制,也指出 IP 的机制仍有待进一步研究。
作者:
Satchel Grant, Victor Gillioz, Jake Ward, Thomas McGrath
学员:
Satchel Grant, Victor Gillioz, Jake Ward
日期:
4月 3, 2026
Claudini:自主研究发现最先进的 LLM 对抗攻击算法
Claude Code 等 LLM 智能体不仅能编写代码,也可用于自主 AI 研究和工程。我们展示了一个由 Claude Code 驱动、采用自主研究式流程的系统,能够发现新的白盒对抗攻击算法,在越狱和提示注入评估中显著超过现有的 30 多种方法。
系统从 GCG 等现有攻击实现出发,不断迭代,最终发现针对 GPT-OSS-Safeguard-20B 的化学、生物、放射性和核相关(CBRN)查询攻击成功率最高可达 40%,而现有算法不超过 10%。这些攻击还具有泛化能力:在代理模型上优化的攻击可直接迁移到留出模型,对 Meta-SecAlign-70B 的攻击成功率达到 100%,而最佳基线为 56%。延续 AutoAdvExBench 的研究,我们的结果初步表明,渐进式安全与安保研究可以由 LLM 智能体自动化完成。白盒对抗红队测试尤其适合这种方法:现有算法提供了良好起点,而优化目标能给出密集、量化的反馈。我们在文中的链接公开所有发现的攻击、基线实现和评估代码。
作者:
Alexander Panfilov, Peter Romov, Igor Shilov, Yves-Alexandre de Montjoye, Jonas Geiping, Maksym Andriushchenko
学员:
Alexander Panfilov
日期:
3月 25, 2026
同一个问题,不同的谎言:用于黑盒检测刻意低表现的跨上下文一致性(C³)
随着语言模型能力提升,准确评估其能力对于安全决策至关重要。如果模型能在危险能力评估中故意表现不佳(即“刻意低表现”),就可能逃过针对其真实能力水平设计的安全措施。我们提出跨上下文一致性(C³),一种通用的无监督黑盒检测框架,利用了一个根本差异:真正缺乏能力的模型,会在改写后的问题中持续表现出困惑;而有能力却假装不行的模型,会在策略性地选择“如何显得能力不足”时暴露出可检测的不一致。我们的框架不依赖特定的一致性指标或汇总方法;我们提供了一种简单实现,使用嵌入余弦距离和均值汇总,无需训练数据或针对模型调整。我们在提示式和微调式刻意低表现情境中进行评估,涵盖指令明确和更自然的设置;在其他黑盒方法失效时,C³ 仍能保留分类信号。研究结果揭示了现有刻意低表现检测方法的局限,也表明一致性检查可有效用于危险能力检测。
作者:
Lin Yulong, Pablo Bernabeu-Perez, Benjamin Arnav, Lennie Wells, Mary Phuong
学员:
Yulong Lin, Benjamin Arnav
日期:
3月 11, 2026
差异挖掘:通过 logit 差异识别微调目标
微调已成为调整语言模型既有行为、引入新行为的标准方法,但微调后究竟出现了哪些行为,往往并不清楚。随着模型能力日益增强,更好地理解微调过程变得越来越重要,尤其因为微调可能带来不希望出现的行为。本文提出差异挖掘(Diff Mining),一种简单有效的框架,通过比较微调模型和基础模型的 logit,识别微调后学到的内容。Diff Mining 能找出微调模型中被强化或抑制的显著 token,即使文本与微调领域无关,这些 token 也能构成模型训练经历的“指纹”。与许多依赖模型内部信息的差异分析方法不同,Diff Mining 只需访问输出 logit,且可扩展到大型模型。框架分为两个模块化步骤:(一)在参考语料上提取微调模型与基础模型逐个上下文的 logit 差异;(二)汇总这些信号,形成一组可解释的 token 来表征微调过程。汇总时,我们探索了简单的 Top-K 频率方法,以及用于将多个微调目标分解为不同 token 簇的非负矩阵分解(NMF)。实验表明,Diff Mining 在多种设置中都有效:在检测微调领域时,无论是识别相关 token,还是让可解释性智能体使用提取出的 token 集合完成下游任务,它都显著优于最先进的模型差异分析方法;对于植入偏见的模型,它无需定向探测就能识别出三分之一以上的偏见。总体而言,该框架有望用于开发检测微调目标的审计工具。
作者:
Greg Kocher, Robert West, Clément Dumas, Julian Minder
学员:
Julian Minder, Clément Dumas
日期:
3月 11, 2026
SL5 AI 安全标准
安全等级 5(SL5)是一种面向 AI 系统的安全态势,适用于那些可能阻碍全球网络能力最强机构执行最高优先级任务的系统。这些机构拥有大量资源、国家级基础设施和比公开最先进水平领先数年的专业能力。SL5 一词源自兰德公司 2024 年的报告《保护 AI 模型权重》(Securing AI Model Weights)[1]。
SL5 标准的首个修订版聚焦于准备周期较长的要求:必须提前数年规划的措施,例如建设设施、采购硬件和发展组织能力。我们优先处理这些要求,因为若要在 2028/2029 年具备 SL5 能力,现在就必须开始准备;等到需求迫切时,这些能力无法临时补齐。有些要求与当前行业惯例相差很大。我们认为,达到这一安全等级需要大胆措施,也有明确机会推动现有和新方案改进,使其适用于 AI 行业并尽可能满足实际运营需要。本组织的成立正是为了开启这项工作。有些要求接近政府级安全能力,私营部门方案可能不足以实现;我们指出了这些差距,并说明政府最终可能需要参与的领域。
本标准由前沿 AI 实验室、政府伙伴和安全专家经过数月持续合作制定。作为 0.1 版,标准预计会随着利益相关方继续参与而得到重要修订。我们诚邀前沿 AI 实验室、政府机构、数据中心运营方和安全研究人员通过直接合作、反馈或实施经验参与这项工作。请发送邮件至 info@sl5.org。
本标准的控制规范采用 NIST SP 800-53 叠加层的形式,原因有三。第一,NIST SP 800-53 经受过实际检验,也是高安全要求组织的标准选择。第二,采用叠加层便于已经实施 NIST 控制措施的组织接纳。第三,这种格式能清楚呈现相对于现有基线“新增或不同”的内容,让 SL5 的变化一目了然,而不必重复既有要求。
达到 SL5 还需要许多其他安全控制措施,包括现有高安全基线中的大部分控制。未来版本将详细说明如何将国防部影响等级 6(IL6)及其参考框架(FedRAMP High、CNSSI 1253)映射到 SL5 要求[4]、[5]。物理安全要求以 ICD 705 SCIF 标准为依据[6]、[7]、[22]、[23];硬件供应链要求参考 NIST SP 800-161 Rev 1[3]。
作者:
Lisa Thiergart, Yoav Tzfati, Peter Wagstaff, Guy, Luis Cosio, Philip Reiner
学员:
Yoav Tzfati
日期:
3月 10, 2026
“只看思维链”何时失灵:压力测试 CoT 监控器的五项任务
思维链(CoT)推理已成为前沿语言模型的标准功能,而监控 CoT 是我们目前发现模型不当行为的最佳方法之一。现有监控基准已被当前 LLM 轻松通过:对于简单检测任务,只需将 CoT 输入 LLM 就往往足够。不过,我们认为,更强大的 CoT 工具能进一步帮助我们理解和控制语言模型行为。为推动开发超越文本表层检查的监控工具,我们提出五项客观任务,对 CoT 监控器进行压力测试:预测推理何时结束、检测自我破坏行为、估计被迫作答的熵、识别谄媚,以及标记异常答案。结果显示,使用特定任务数据训练的定制方法能够取得较好表现,但现成方法和标准 LLM 监控器难以泛化。通过提供这些数据集和基线结果,我们为开发更稳健的监控技术建立了一个测试平台。
作者:
Daria Ivanova, Riya Tyagi, Joshua Engels, Neel Nanda
学员:
Daria Ivanova, Riya Tyagi
日期:
3月 5, 2026
AI 研究人员如何看待 AI 研发自动化与智能爆发
许多领先的 AI 研究人员认为,AI 发展带来的变革可能超过以往所有技术革命。这一判断基于一种可能性:AI 能够自动化 AI 研究本身,从而形成正反馈循环。2025 年 8 月和 9 月,我们采访了 25 位前沿 AI 实验室和学术界的研究人员,包括来自 Google DeepMind、OpenAI、Anthropic、Meta、加州大学伯克利分校、普林斯顿大学和斯坦福大学的参与者,了解他们对这些情景的看法。尽管 AI 系统目前还不能递归式地自我改进,25 位受访者中仍有 20 位认为,自动化 AI 研究是最严重、最紧迫的 AI 风险之一。受访者普遍预计,AI 智能体会逐渐提升编程、数学乃至 AI 开发能力,并从“助手”或“工具”转变为“自主 AI 开发者”;至于之后会发生什么,大家的预测便出现分歧。研究人员虽然认同递归改进有可能发生,但对时间表和适当的治理机制等基本问题意见不一。例如,前沿实验室研究者和学术研究者之间出现了认识差异,后者对爆发式增长情景更加怀疑。此外,25 位受访者中有 17 位预计,具备先进编程或研发能力的 AI 系统会越来越多地留在 AI 公司或政府内部使用,不向公众开放。对于设立监管“红线”是否可取,受访者意见不一,但几乎所有人都支持以透明度为基础的缓解措施。
作者:
Severin Field, Raymond Douglas, David Krueger
学员:
Severin Field
日期:
3月 5, 2026
受内容审查的 LLM:探索隐藏知识的自然测试平台
大语言模型有时会给出错误或误导性回答。应对这一问题有两种方法:引导模型诚实作答——修改提示或权重,让模型如实回答;以及谎言检测——判断某个回答是否错误。以往研究会在专门训练来撒谎或隐瞒信息的模型上评估这些方法,但人为构造的情境可能与自然发生的不诚实行为不同。我们改为研究中国开发者提供的开放权重 LLM,这些模型经过训练,会审查政治敏感话题。Qwen3 模型经常对法轮功或天安门抗议等主题作出错误陈述,但有时又能正确回答,表明模型掌握了被训练为压下去的知识。我们以此为测试平台,评估一系列引导作答和谎言检测技术。对于引导诚实作答,去掉聊天模板、少样本提示,以及使用通用诚实数据微调,最能稳定地提高真实回答比例。对于谎言检测,让被审查模型判断自己的回答是否真实,表现接近未经审查模型所能达到的上限;使用无关数据训练的线性探针则提供了成本更低的替代方案。效果最强的诚实性引导技术也能迁移到包括 DeepSeek R1 在内的前沿开放权重模型。值得注意的是,没有任何一种技术能完全消除错误回答。我们公开了所有提示、代码和对话记录。
作者:
Helena Casademunt, Bartosz Cywiński, Khoi Tran, Arya Jakkli, Samuel Marks, Neel Nanda
学员:
Helena Casademunt, Bartosz Cywiński, Khoi Tran, Arya Jakkli
日期:
3月 5, 2026
推理模型难以控制自己的思维链
思维链(CoT)监控是一种有前景的工具,可用于发现现代推理模型的不当行为并理解其动机。然而,如果模型能控制自己在 CoT 中说出什么内容,CoT 监控能力就可能被削弱。我们提出 CoT-Control 评估套件,用于衡量这种不良能力——CoT 可控性。套件包含一些任务,要求模型在遵守 CoT 指令的同时解决问题,例如回答遗传学问题时不能使用“染色体”一词。我们发现,推理模型控制 CoT 的能力显著低于控制最终输出的能力。例如,Claude Sonnet 4.5 只有 2.7% 的时候能控制 CoT,但控制最终输出时的成功率为 61.9%。我们还发现,较大模型的 CoT 可控性更高;随着强化学习训练增加、测试时算力提高、问题难度上升,可控性会降低。即使模型受到激励(而非直接要求)去规避 CoT 监控,可控性仍然较低;不过,当模型知道自己正在受监控时,可控性会略有提高。通过对抗式提示优化来诱导模型控制 CoT,也无法显著提升可控性。结果让我们谨慎地乐观认为,目前 CoT 可控性不太可能成为 CoT 可监控性的失效模式。但其可控性低的机制尚未得到充分理解。鉴于 CoT 可控性对维持 CoT 可监控性很重要,我们建议前沿实验室在未来模型中持续追踪这一指标。
作者:
Chen Yueh-Han, Robert McCarthy, Bruce W. Lee, He He, Ian Kivlichan, Bowen Baker, Micah Carroll, Tomek Korbak
学员:
John Chen, Robert McCarthy, Bruce Lee
日期:
3月 5, 2026
前沿模型能以极低概率采取特定行动
部署前评估只能抽查有限数量的模型行为。试图逃避监督的恶意模型可能利用这一点,通过随机化“背离”发生的时机来躲避检测:在评估期间极少出现不当行为,却在部署后频繁到足以造成伤害。但这要求模型能以极低的概率采取行动,同时保持概率校准。前沿模型是否具备这种能力?我们提示 GPT-5、Claude-4.5 和 Qwen-3 系列模型,以极低的目标概率采取某个行动(例如 0.01%);有时直接给出目标概率,有时要求模型自行推导,然后评估其校准程度,即反复抽样时,模型采取目标行动的频率是否大致为万分之一。我们发现,前沿模型在这项任务上的表现出人意料地好。若上下文中存在熵来源(例如 UUID),模型在低于十万分之一的行动概率下仍能保持良好校准。没有外部熵时,部分模型仍能达到低于万分之一的概率。直接给定目标概率时,较大的模型在更低概率下也能实现良好校准;但如果需要模型自行推导最佳目标概率,所有模型在没有熵来源或生成熵的提示时都无法校准成功。成功实现低概率策略需要显式思维链(CoT)推理,因此目前尝试这种方法的恶意模型可能会被 CoT 监控器发现。不过,随着模型能力提升,未来评估可能无法继续依赖模型缺乏目标概率校准能力这一特点,尤其当 CoT 不再清晰可读时。
作者:
Alex Serrano, Wen Xing, David Lindner, Erik Jenner
学员:
Alex Serrano, Wen Xing
日期:
3月 2, 2026
Olmo 的价值观从何而来?
后训练极为重要:它让 LLM 从下一个 token 预测器变成通用助手。然而,后训练数据的筛选往往依赖启发式方法和经验,其效果也大多是在训练完成后才理解。本文通过考察 Olmo-3-7B-Instruct 在何时、如何学到其价值观,来研究后训练的影响。我们首先量化模型在后训练期间的价值观变化,发现安全相关价值观在监督微调(SFT)阶段上升,在直接偏好优化(DPO)阶段下降。进一步分析 DPO 后,我们发现,只用数据集,无需训练模型,就能通过计算 DPO 样本上的激活差异与价值方向的点积,预测价值观变化(Spearman 相关性)。不过,令人意外的是,DPO 期间观察到的大部分价值变化都来自 Olmo 更不容易拒绝回答;我们的方法很可能只是捕捉到了这个更简单的潜在价值。即便如此,结果仍表明,我们在一定程度上可以定位训练过程中价值观发生变化的环节,并且仅凭训练数据预测变化方向。我们期待未来进一步研究这些问题。
作者:
Arthur Conmy, Joshua Engels
学员:
Lily Sun
日期:
3月 1, 2026
通过强化学习训练干预缓解奖励作弊
强化学习(RL)是 LLM 后训练的核心环节,但奖励函数并不能完美代表我们希望模型表现出的行为,模型常会利用奖励设计中的漏洞进行“奖励作弊”。这会削弱训练过程的可信度,甚至可能泛化为更广泛的失配。本文提出并开源两个能够诱发 Qwen3-4B 奖励作弊的环境:一个编程环境允许模型覆盖评测测试;另一个医疗对话环境会对谄媚行为给予部分奖励。我们利用这两个环境比较三类奖励作弊缓解方法:惩罚检测到作弊行为的运行轨迹、对这些轨迹施加负奖励,以及使用接种式提示。表现最好的干预方法达到与在无法作弊环境中训练的模型相当的表现,同时没有显著增加奖励作弊行为。结果表明,训练期间的干预有望用于控制奖励作弊,同时也凸显了监控不完善以及不同训练运行之间表现不一致所带来的挑战。
作者:
Joshua Engels, Neel Nanda
学员:
Aria Wong
日期:
3月 1, 2026